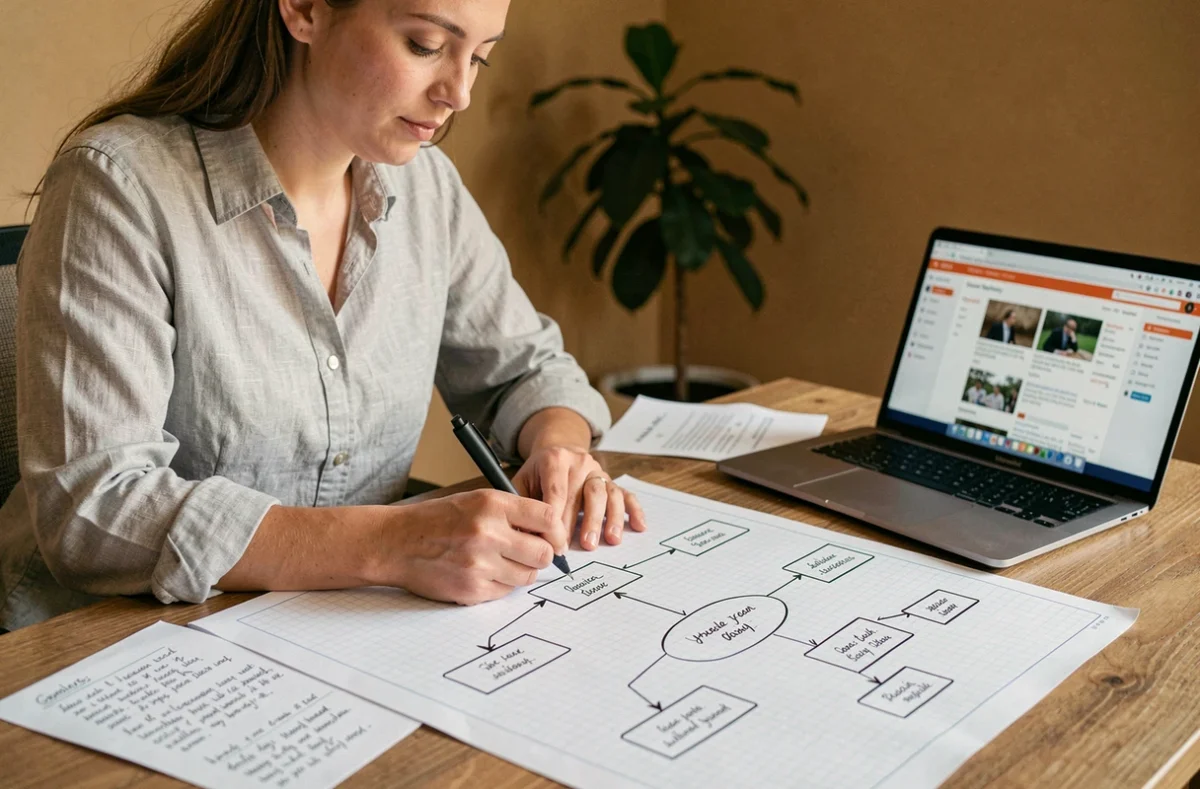
Un blog de cinquante articles sans catégories claires, c’est un tiroir où tout est en vrac : le lecteur cherche, ne trouve pas, et ferme l’onglet. Le plan du site d’un blog ne se limite pas à un fichier XML envoyé à Google. C’est d’abord une architecture de liens internes qui guide la navigation humaine et le crawl des moteurs de recherche.
Sitemap XML et architecture de navigation : deux fonctions distinctes
On confond souvent le sitemap XML avec le plan de site visible par les visiteurs. Le fichier XML sert à signaler des URL aux robots d’indexation. Google le considère comme un signal de découverte, pas comme une garantie de positionnement.
Une page ajoutée uniquement dans le sitemap XML, sans lien depuis la navigation ou depuis d’autres articles, reste faiblement reliée au reste du blog. Les robots la trouvent, mais lui accordent peu de poids. À l’inverse, un article lié depuis une catégorie, depuis des contenus complémentaires et depuis une page pilier bénéficie d’un maillage qui renforce sa visibilité.
Le plan du site visible, lui, remplit un rôle différent : il offre aux visiteurs une vue d’ensemble de l’arborescence. Sur un blog qui publie régulièrement, cette page devient un point d’entrée alternatif au menu principal. On peut observer comment fonctionne un plan du site AllBlogger Tips pour visualiser ce type d’organisation appliquée à un blog actif.
En pratique, on a besoin des deux. Le XML pour le référencement technique, la page de plan de site pour l’expérience utilisateur. Négliger l’un ou l’autre laisse un angle mort.
Catégories et maillage interne : la colonne vertébrale du plan de site blog
Avant de dessiner un plan, on doit régler la question des catégories. C’est là que la plupart des blogs accumulent de la dette technique sans s’en rendre compte.
Limiter le nombre de catégories pour garder une arborescence lisible
Un blog avec quinze catégories dont certaines ne contiennent que deux articles envoie un signal dispersé. Chaque catégorie devrait regrouper un volume suffisant de contenus pour justifier son existence dans le menu. Si on hésite entre deux catégories proches, mieux vaut les fusionner et utiliser des étiquettes pour affiner le tri.
Chaque article doit appartenir à une seule catégorie principale. Les affectations multiples créent des doublons dans l’arborescence et brouillent la hiérarchie pour les moteurs comme pour les lecteurs.
Relier les articles entre eux avec des liens contextuels
Le maillage interne ne se résume pas à placer un bloc « articles similaires » en bas de page. Les liens les plus efficaces sont ceux insérés dans le corps du texte, là où le lecteur a une raison de cliquer parce que le sujet lié approfondit ce qu’il est en train de lire.
- Chaque nouvel article devrait contenir au moins deux liens vers des contenus existants du même blog, dans des paragraphes où le sujet s’y prête naturellement.
- Les articles anciens à fort trafic méritent une mise à jour ponctuelle pour y ajouter un lien vers les publications récentes sur le même thème.
- Une page pilier (un guide long et structuré) peut servir de hub central pour une catégorie entière, avec des liens vers et depuis chaque article satellite.
Ce travail de liaison interne a un effet direct sur la profondeur de crawl. Un article accessible en deux clics depuis la page d’accueil sera exploré plus fréquemment qu’un article enfoui à quatre niveaux de profondeur.
Construire un plan de site HTML qui améliore la navigation
La page de plan de site HTML n’a pas besoin d’être sophistiquée. Elle doit être fonctionnelle.
Structure recommandée pour un blog
On organise la page par catégories, chaque catégorie listant ses articles par ordre logique (chronologique ou thématique selon le blog). Le visiteur qui arrive sur cette page doit pouvoir scanner l’ensemble du contenu en quelques secondes.
- Un titre de section par catégorie, suivi de la liste des articles avec leur titre cliquable.
- Pas de descriptions longues : le titre de l’article suffit à indiquer le sujet.
- Un lien vers cette page de plan de site placé dans le pied de page du blog, accessible depuis n’importe quelle page.
- Sur WordPress, des extensions génèrent cette page automatiquement et la mettent à jour à chaque publication.
Une page plan de site à jour réduit le nombre de pages orphelines, ces articles que personne ne trouve parce qu’aucun lien n’y mène. Si un article n’apparaît ni dans le menu, ni dans les catégories, ni dans le maillage interne, la page de plan de site reste son dernier filet de sécurité.
Cohérence du sitemap XML : les erreurs qui freinent l’indexation
Côté technique, un sitemap XML mal entretenu fait plus de dégâts qu’un sitemap absent. Les retours varient sur ce point selon les configurations, mais quelques règles restent constantes.
Le sitemap ne doit contenir que des URL canoniques, accessibles et répondant en HTTP 200. Inclure des pages redirigées, des URL en erreur 404 ou des pages marquées noindex crée des signaux contradictoires. Google reçoit une liste d’URL à explorer, constate que certaines sont inaccessibles ou bloquées, et perd en confiance sur la fiabilité de l’ensemble du fichier.
Après une refonte, un changement de structure de catégories ou une suppression d’articles, il faut vérifier trois choses : que le sitemap a été régénéré, que les redirections 301 sont en place pour les anciennes URL, et qu’aucune page orpheline ne subsiste dans l’index. Soumettre un nouveau sitemap sans vérifier les redirections ne protège pas le référencement acquis.
Sur WordPress, la plupart des extensions SEO régénèrent le sitemap automatiquement. Mais elles n’ajoutent pas les redirections à votre place, et elles n’identifient pas les articles devenus orphelins après une réorganisation de catégories.
Un plan de site efficace repose sur la cohérence entre ce que voit le visiteur et ce que lit le robot. Si la navigation HTML, le maillage interne et le sitemap XML racontent la même histoire, le blog gagne en lisibilité pour tout le monde. Quand ces trois couches se contredisent, c’est le référencement qui trinque en premier.